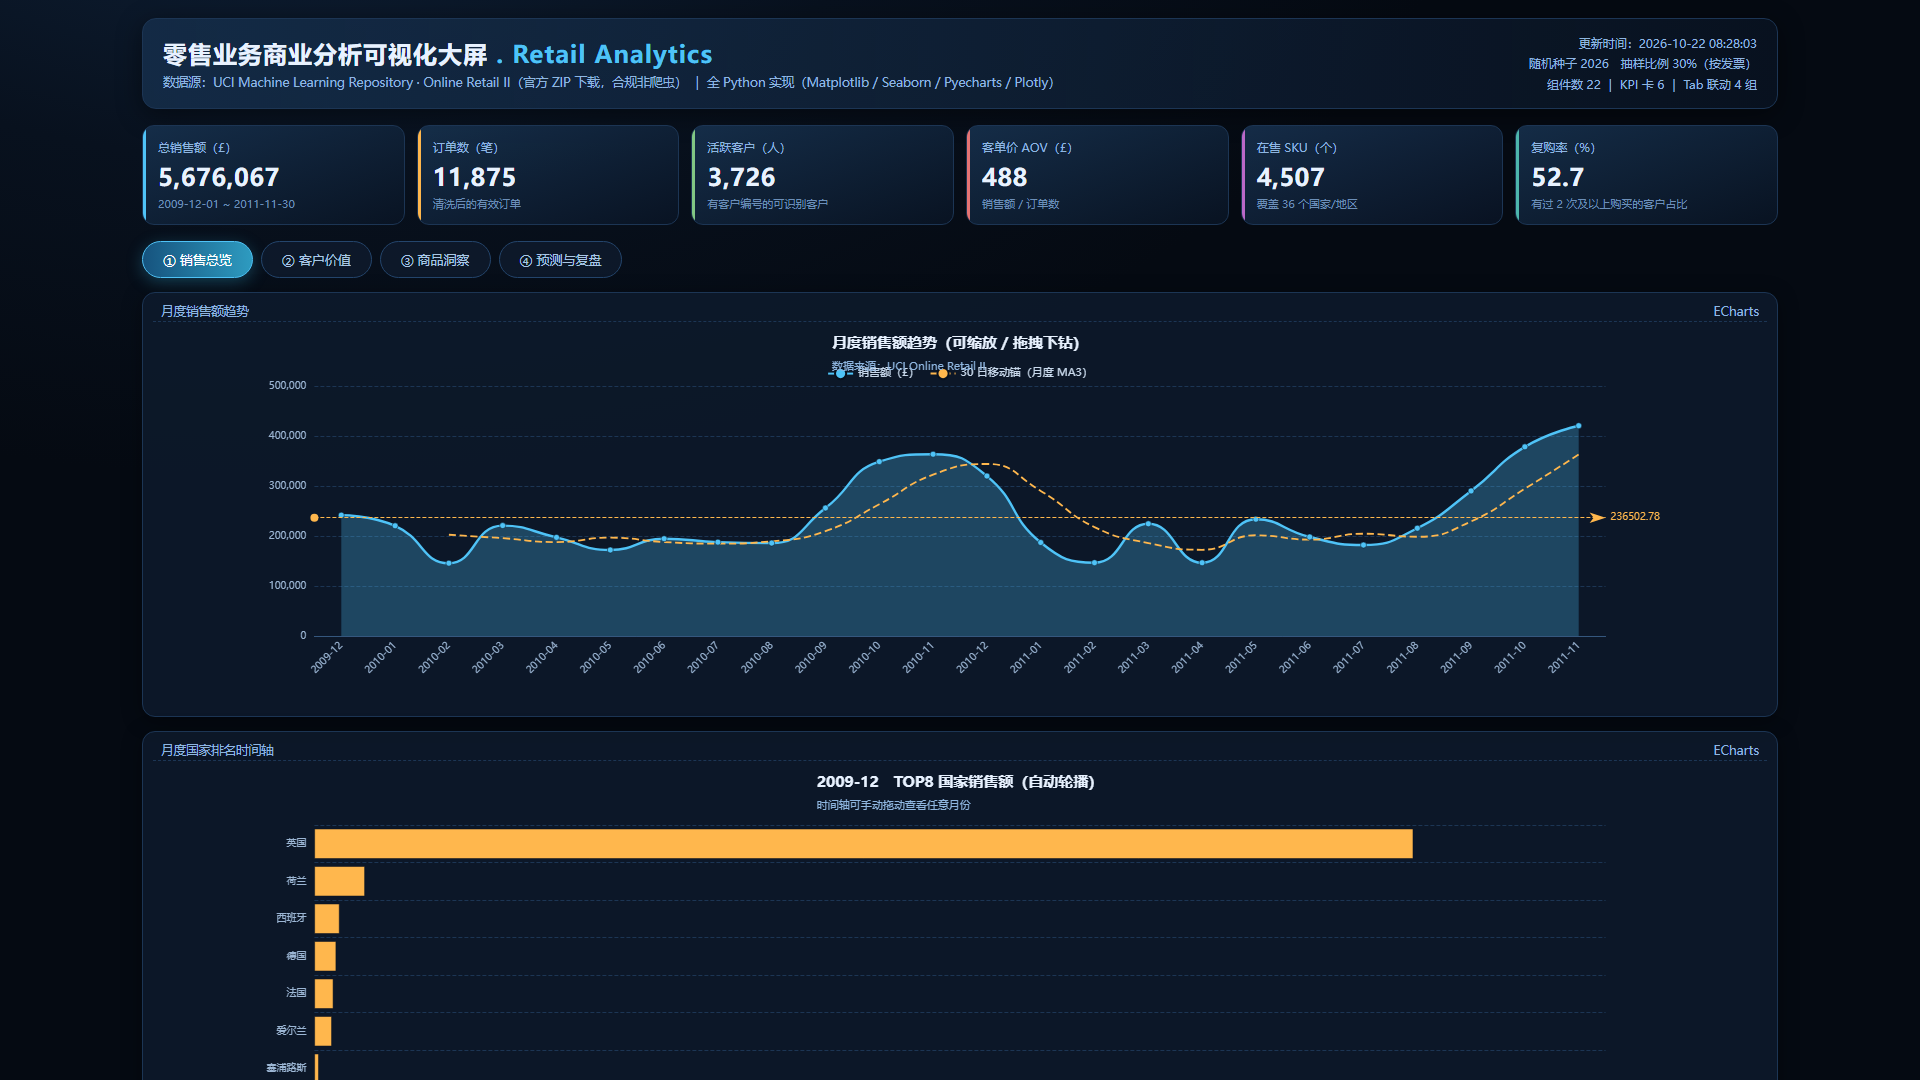
Tab ① 销售总览KPI 卡 + 销售趋势 + 月度排名时间轴
统计口径:清洗后有效明细 302,786 行,分析窗口 2009-12-01 ~ 2011-11-30(剔除不完整的末月)。
Pyecharts 生成 · 暗色主题 · 4 个标签页 · 20 个联动组件(KPI 卡 / 趋势图 / 结构图 / 热力图 / 漏斗 / 词云 / 明细表 / 时间轴筛选器)。
由 scripts/10_dashboard_screenshots.py 调用本机无头浏览器对离线大屏逐标签页实拍(1920×1080),并合成轮播 GIF——作为评分标准中「大屏演示截图或录屏」创新加分材料提交,论文中同步收录(图 5-7)。
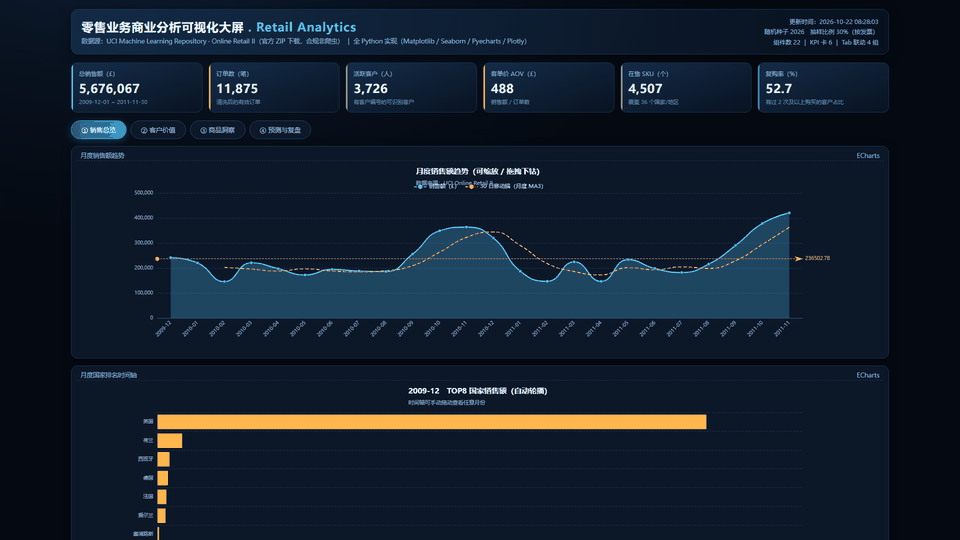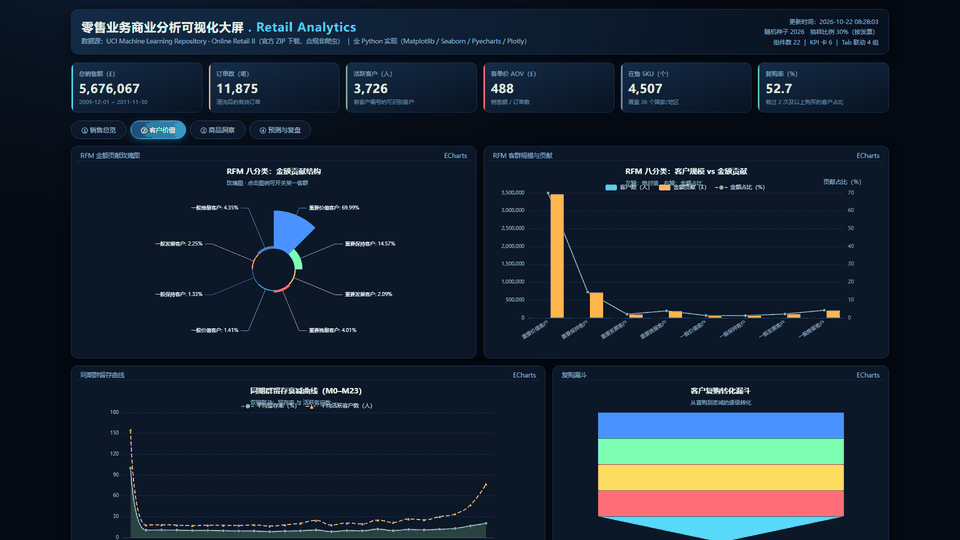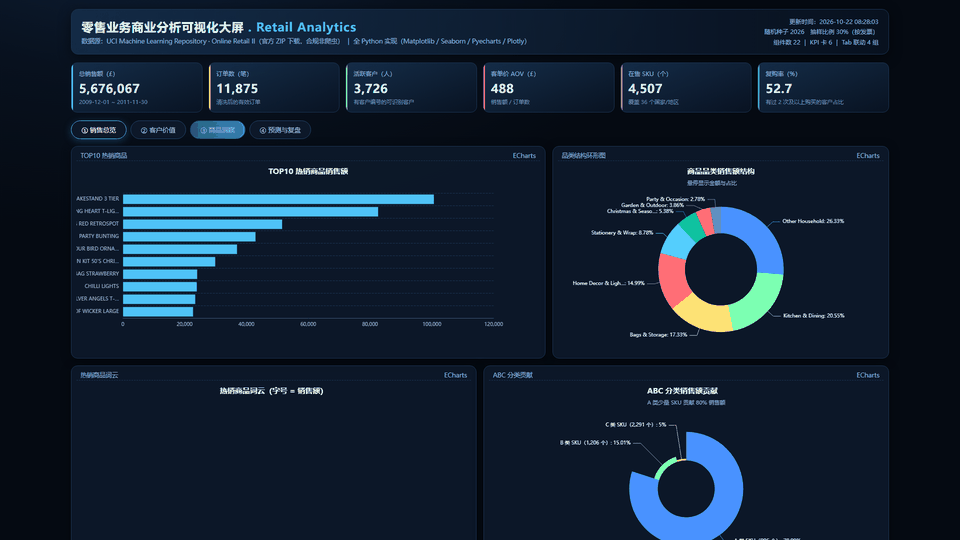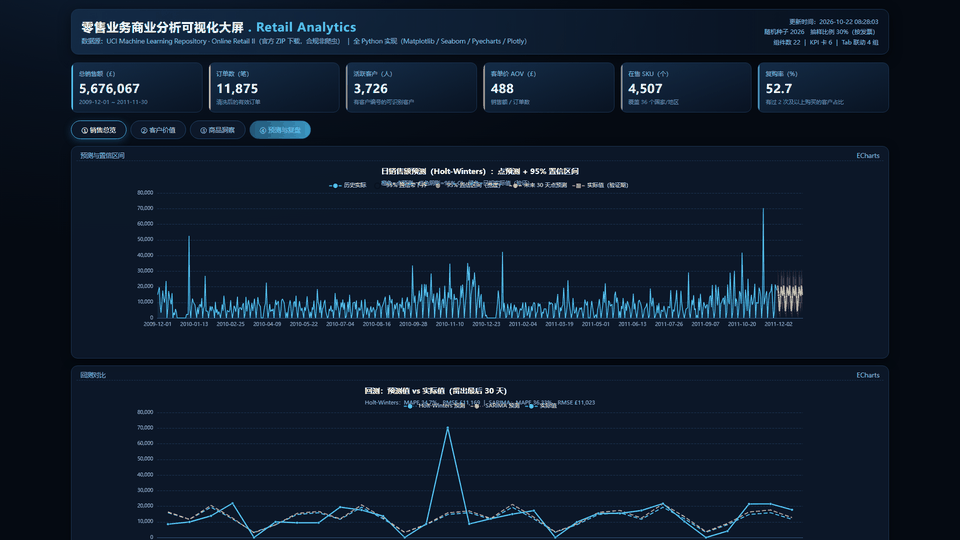
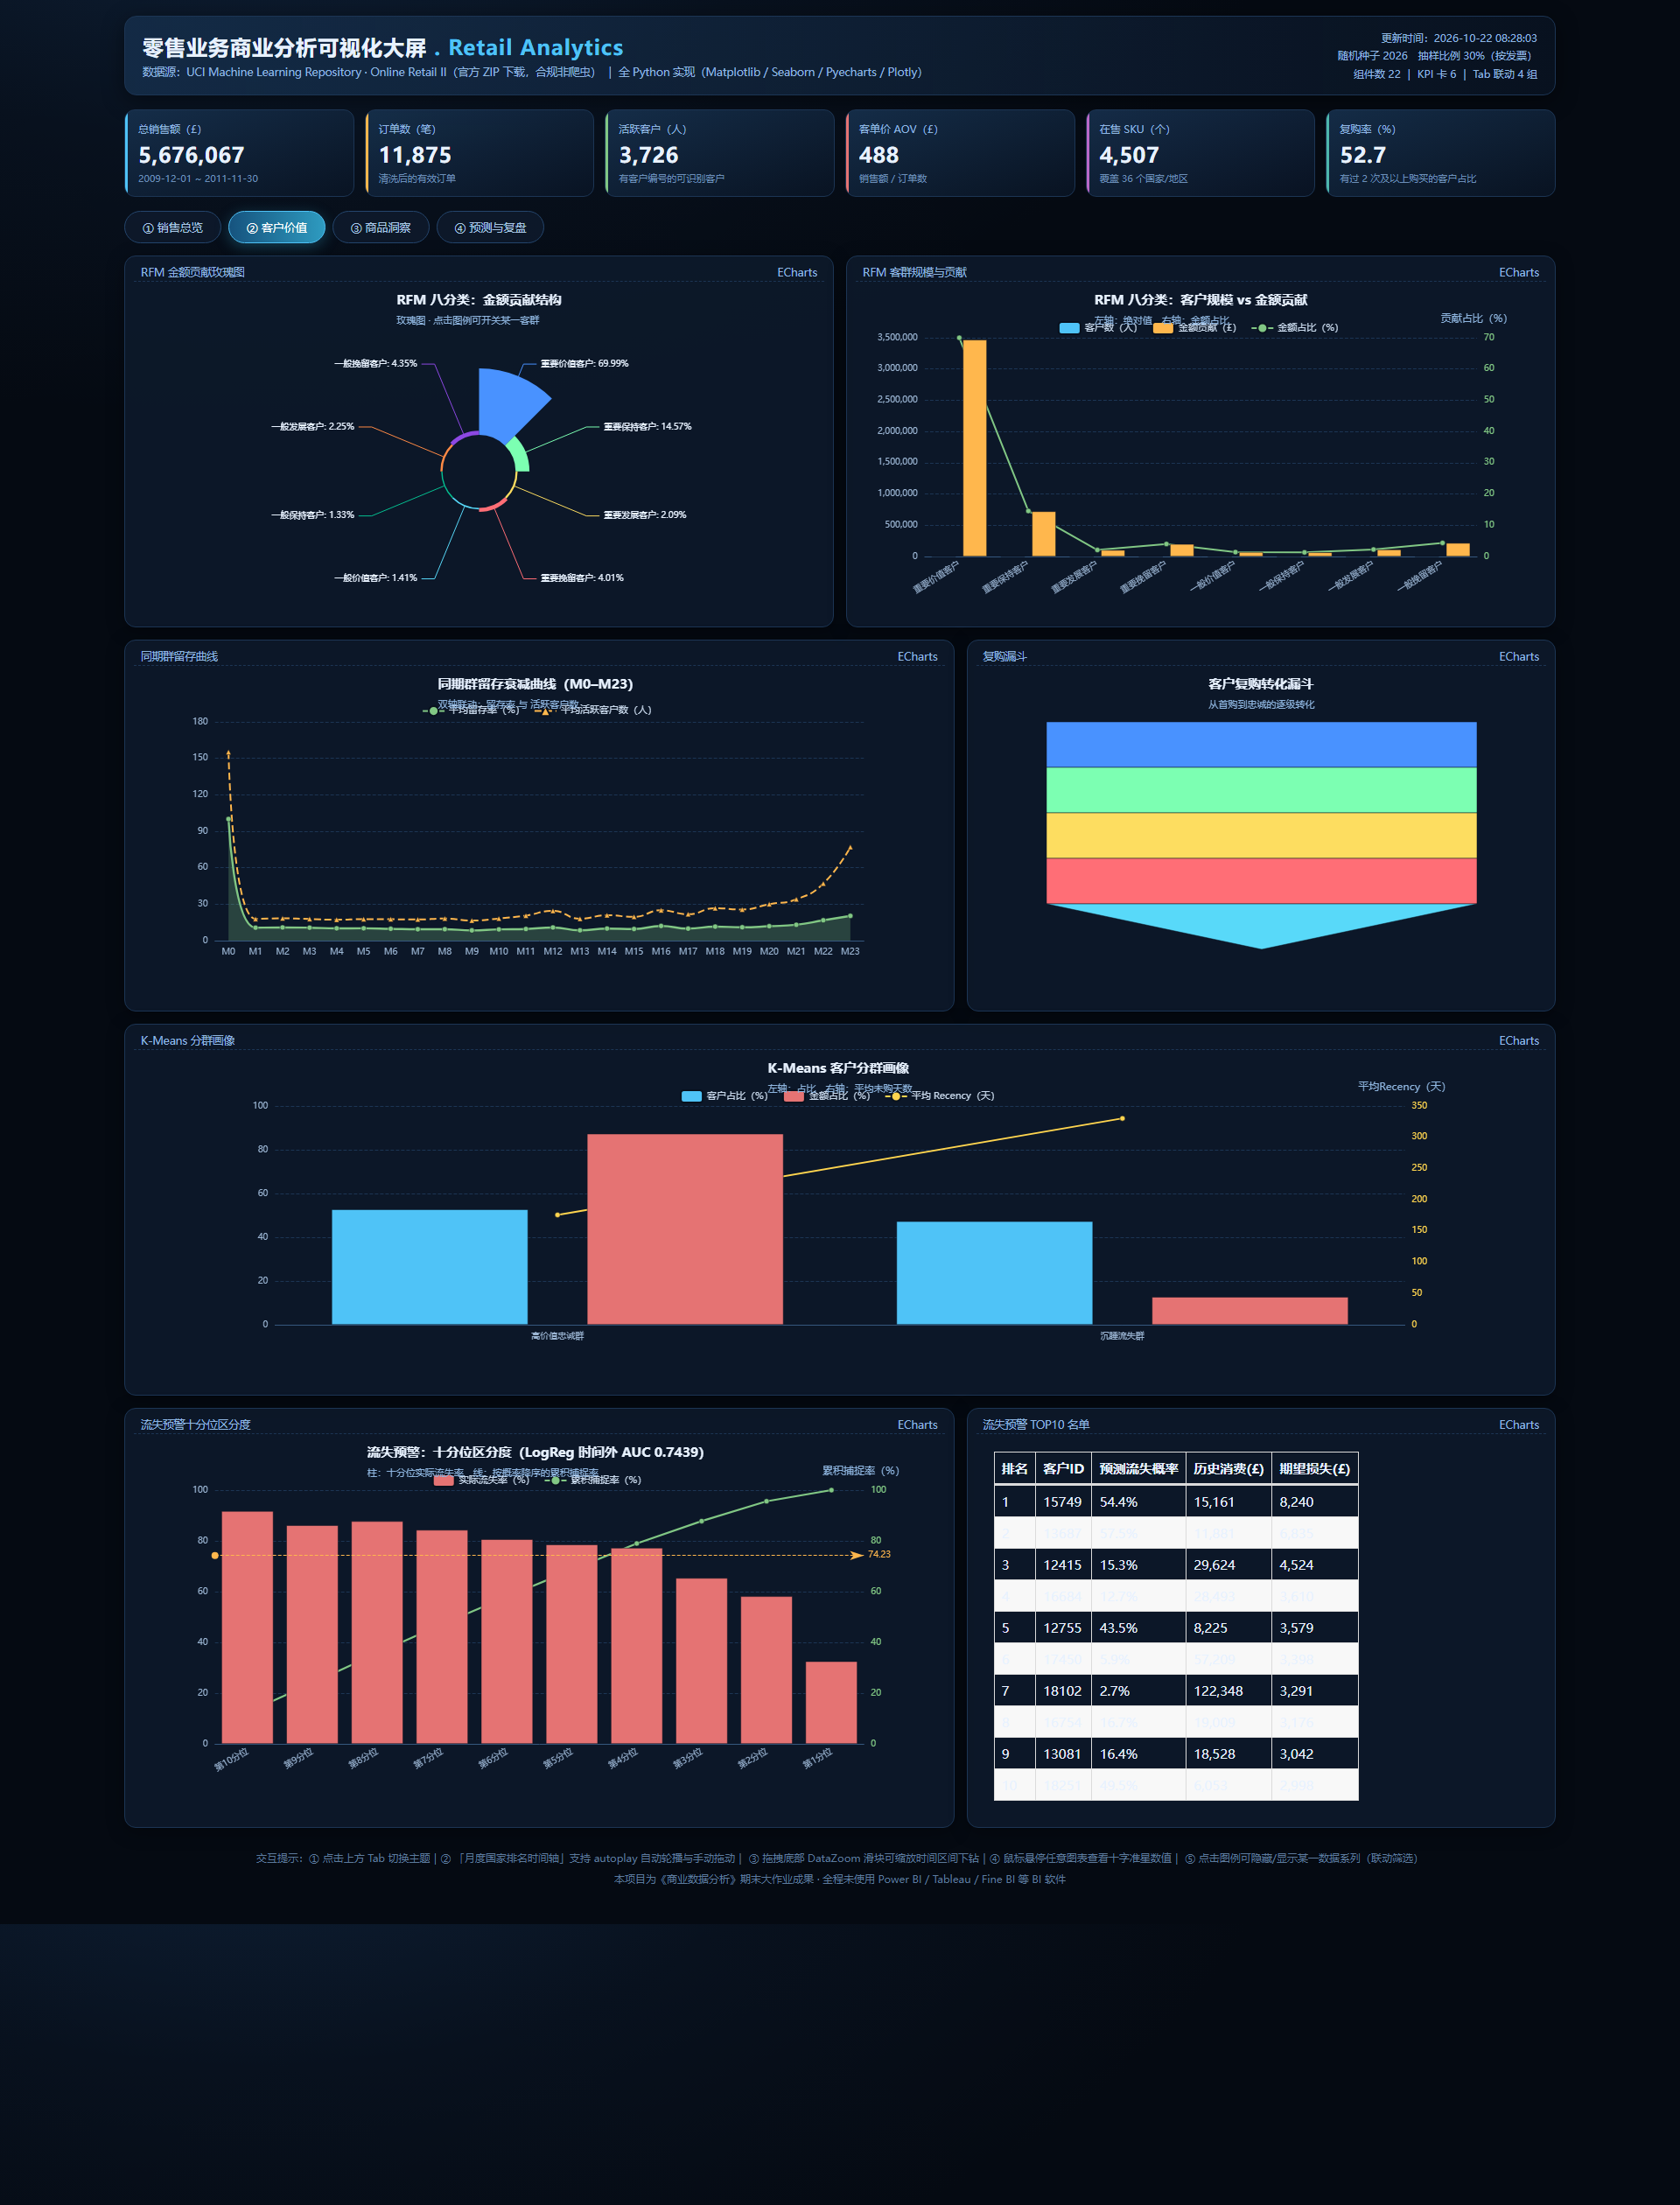
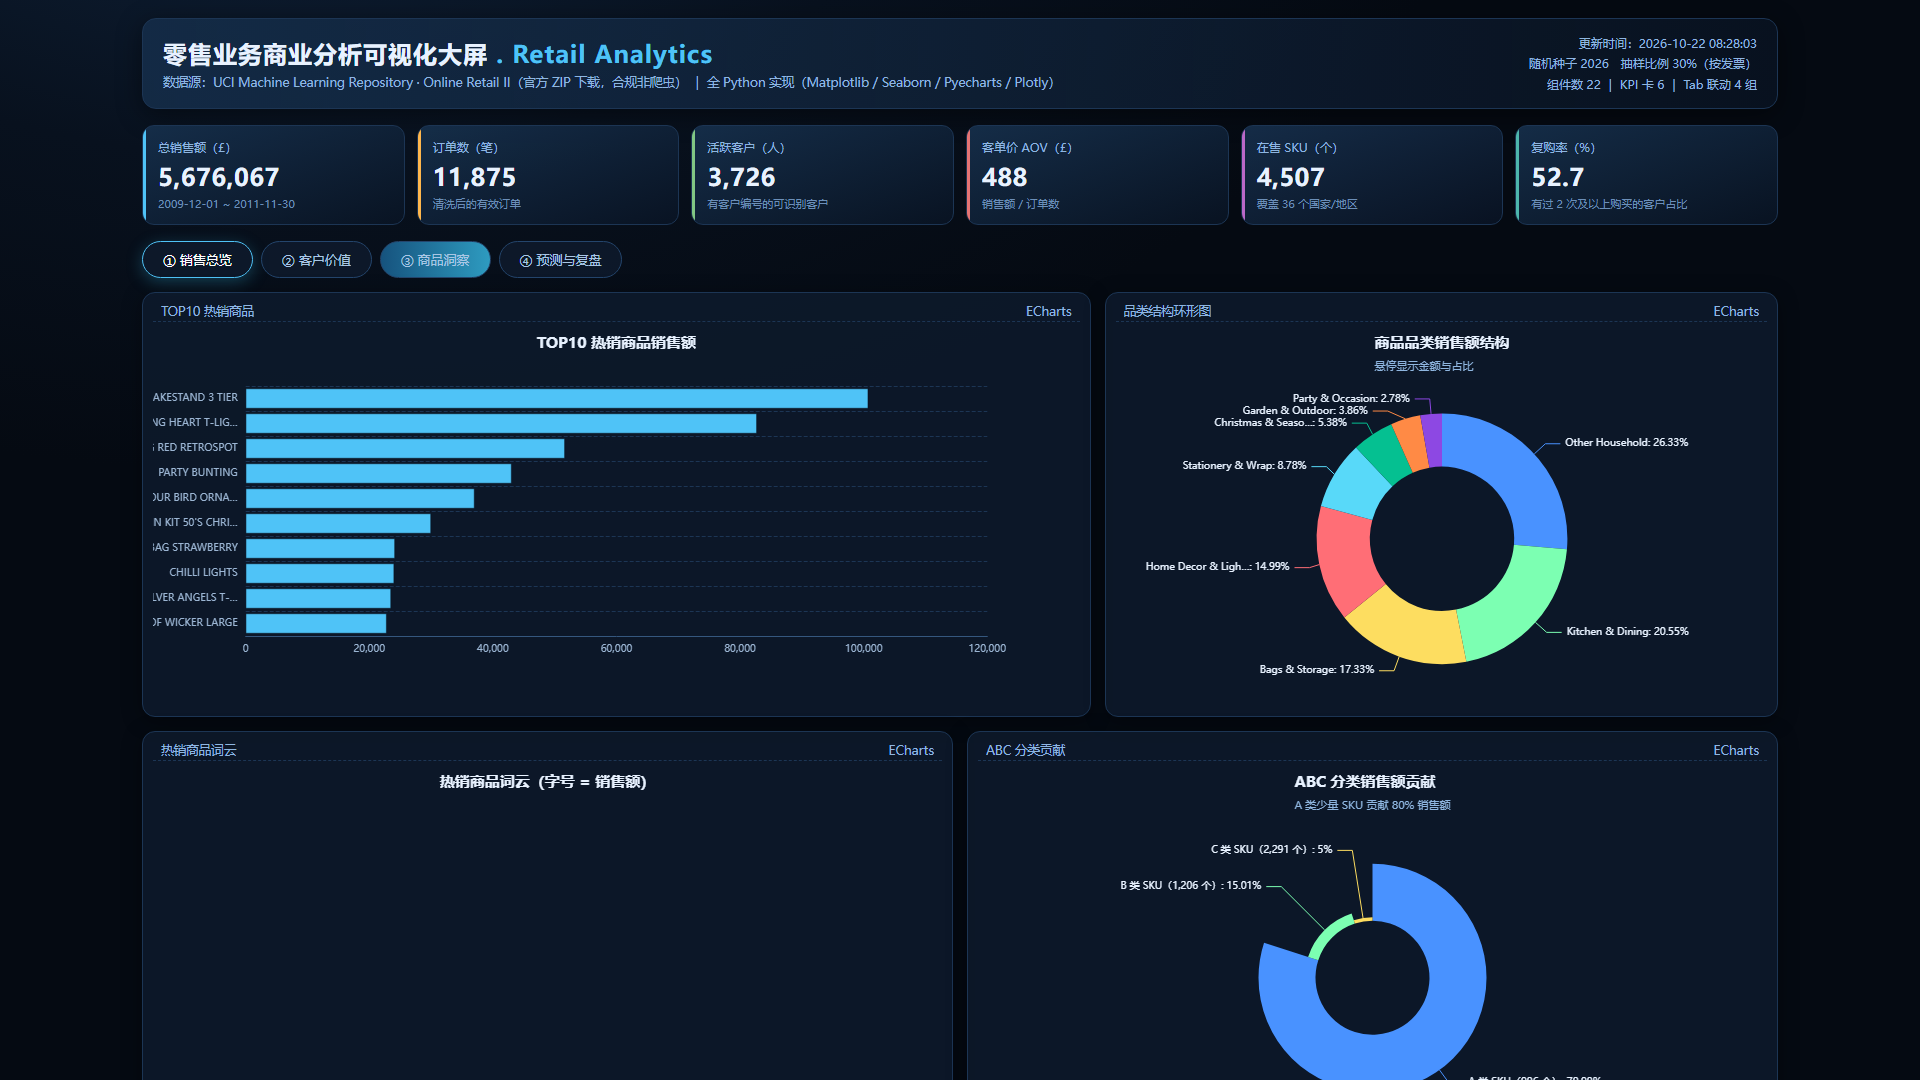
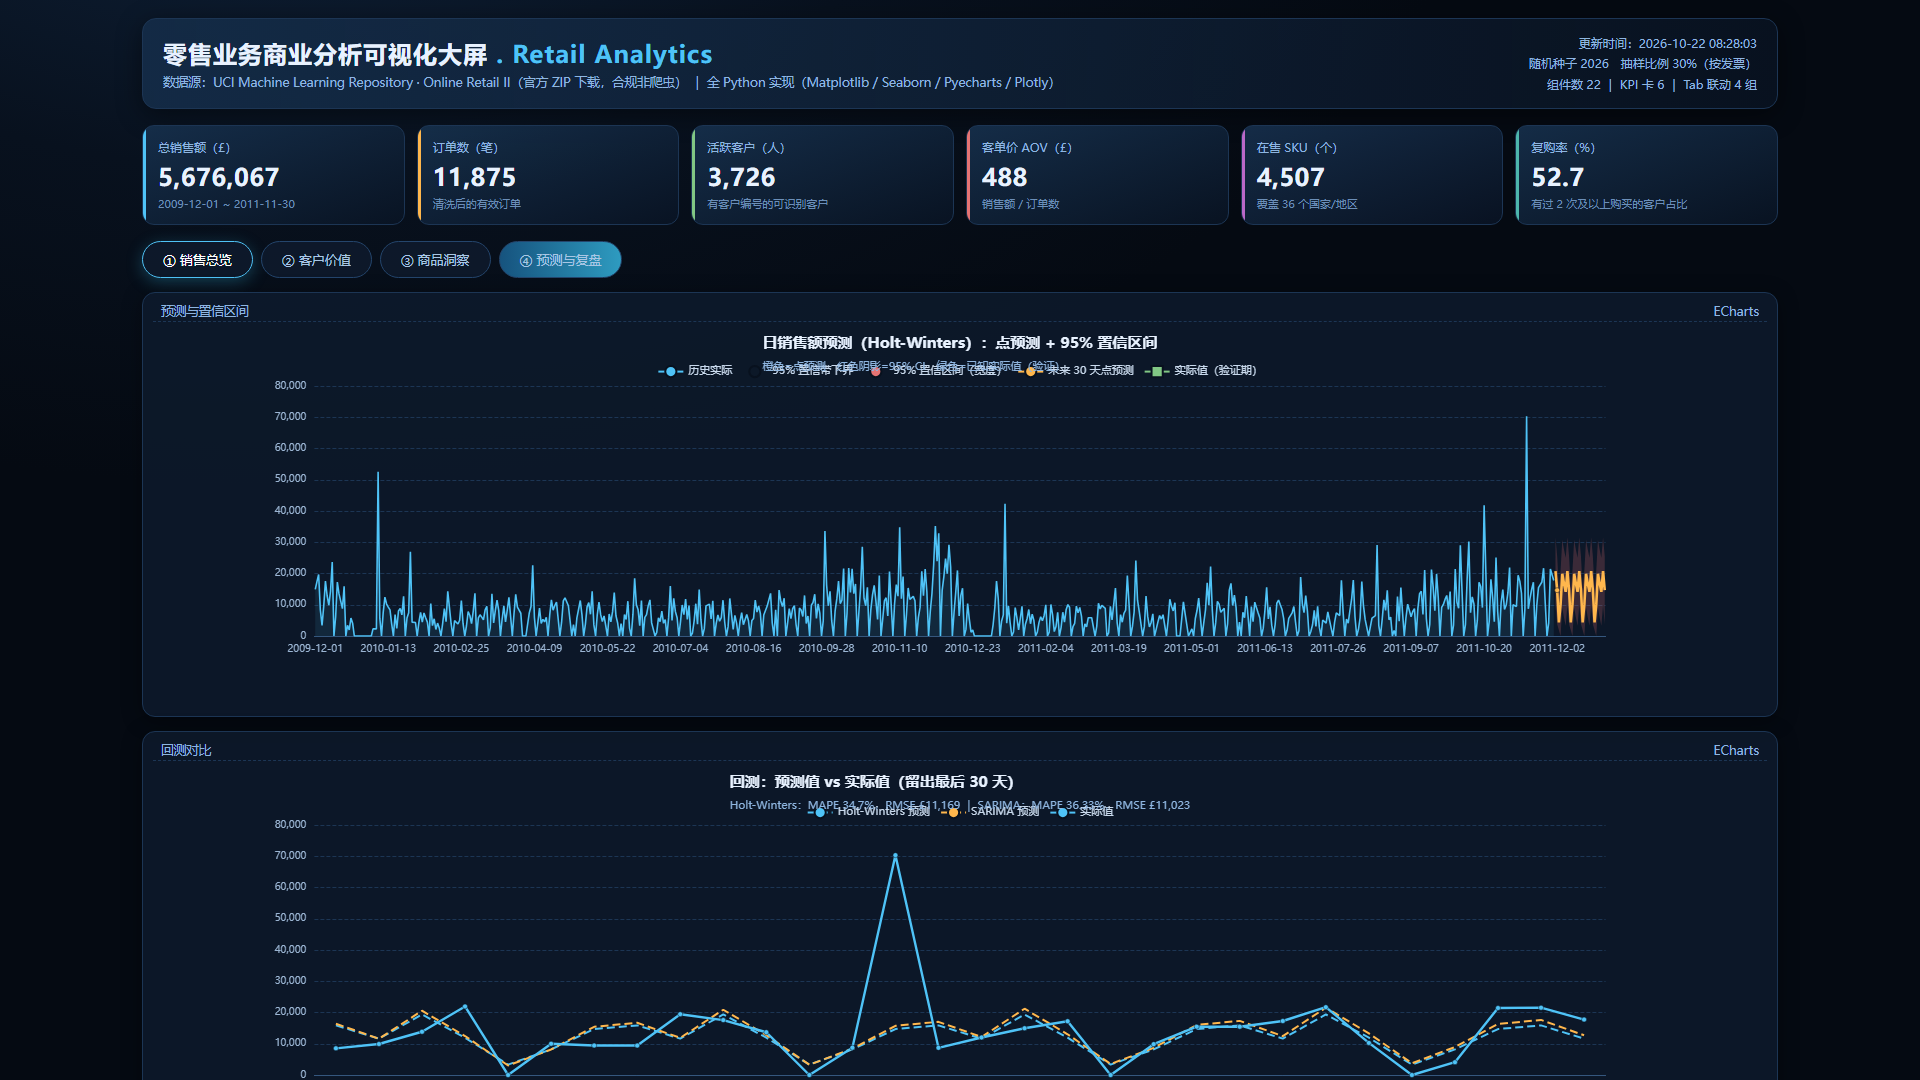
对照《Excel 数据可视化——从图表到数据大屏》复现 23 种模板图型 + 10 张业务模型图。点击任意图表可放大查看。
10 类模型覆盖「卖什么 / 卖给谁 / 接下来会怎样」三大决策场景,每个参数与阈值均给出业务依据,并对关键阈值做了稳健性检验。
| # | 模型 | 关键参数与业务依据 | 核心图 |
|---|---|---|---|
| M1 | 环比/同比 + 移动平均 | MA7 / MA30 / MA90 多周期平滑;剔除不完整末月(2011-12 仅 9 天) | fig01 · fig25 |
| M2 | RFM 八分类 | 中位数切分(分布右偏,抗极值):R = 203 天,F = 2 次,M = £488.69 | fig26 · fig27 |
| M3 | 同期群留存 | 月度粒度(周太碎、季太粗);保留率矩阵对角线 = 100% 用于验证计算 | fig28 |
| M4 | 帕累托 / ABC 分类 | A = 累计 80%,B = 累计 95%;销售额口径 | fig29 |
| M5 | Apriori 关联规则 | support ≥ 0.01(有铺货价值)/ lift > 1.0(正向关联)/ conf ≥ 0.15(推荐可命中) | fig30 · fig31 |
| M6 | 波士顿矩阵 | 相对份额阈值 1.0(BCG 经典分界);增速阈值取大盘同比 7.62% | fig32 |
| M7 | SARIMA / Holt-Winters | 周周期 7 天;30 天留出回测;输出点预测 + 95% 置信区间 | fig33 |
| M8 | K-Means 用户分群 | 分位数变换→正态(消除 RFM 右偏);K 由轮廓系数确定(K = 2,0.7412);seed = 2026 | fig34 |
| M9 | 复购漏斗 | 五级转化,定位「第 2 次购买」瓶颈 | fig35 |
| M10 | 客户流失预警 | 观测窗/表现窗严格切分防泄漏;LogReg 主模型 + 时间外验证 + 能力边界检验 | fig36/37 |
预测回测结果(测试集 30 天)
| 模型 | 阶数 | MAPE | RMSE | AIC | 选用 |
|---|---|---|---|---|---|
| Holt-Winters | 加法趋势(阻尼) + 加法季节(7) | 34.70% | £11,169 | — | 选用 |
| SARIMA | (1,1,1)(1,0,1,7) | 36.33% | £11,023 | 13,879.5 |
稳健性检验① RFM 切分方式是否影响结论
| 切分方式 | 阈值 R / F / M | 核心客群人数 | 人数占比 | 营收占比 |
|---|---|---|---|---|
| 中位数(采用) | 203 天 / 2.00 次 / £488.69 | 1,069 | 28.69% | 69.99% |
| 均值 | 249 天 / 2.89 次 / £1,329.56 | 572 | 15.35% | 61.43% |
| 60 分位 | 126 天 / 2.00 次 / £671.73 | 784 | 21.04% | 62.84% |
三种方案下「不足三成客户贡献六成以上营收」的结构均成立,结论稳健;同时可见均值切分会少识别约 500 名可运营客户,反向印证了采用中位数的理由。
稳健性检验② K-Means:K = 2 是数据本身的断点,而非参数没调好
| 证据 | 对比口径 | 结果 | 结论 |
|---|---|---|---|
| 预处理方式 | log1p+Z-score / 99%缩尾 / 分位数变换 | 0.4271 / 0.4269 / 0.7412 | 低分是方法问题,不是数据问题 |
| 特征集(K=2) | R/F/M 三维 / +AOV / +Tenure | 0.7412 / 0.6808 / 0.6364 | 多加特征反而更差(共线与噪声) |
| 算法一致性 | K-Means / Ward / GMM(K=2) | 0.7412 / 0.7412 / 0.7412 | 三算法划分完全相同,与算法无关 |
| bootstrap 稳定性 | 重采样 100 次的 ARI(K=2) | 1.0000(K=6 仅 0.7770) | 扰动样本划分纹丝不动 |
最有力的一条证据:高价值忠诚群 1,965 人全部购买过 2 次以上,沉睡流失群 1,761 人全部只买过 1 次,无一例外。无监督算法自动切出的分界精确落在「是否完成第 2 次购买」上,而 1,965 ÷ 3,726 = 52.74%,与复购漏斗独立算出的复购率完全相等。
稳健性检验③ 波士顿矩阵增速口径
| 品类 | YoY(%) | 趋势年化(%) | 趋势 R² | t 值 | 象限一致 |
|---|---|---|---|---|---|
| Party & Occasion | 50.52 | 57.77 | 0.370 | 3.60 | 一致 |
| Christmas & Seasonal | 40.61 | 155.26 | 0.131 | 1.82 | 一致 |
| Bags & Storage | 26.53 | 37.53 | 0.348 | 3.42 | 一致 |
| Home Decor & Lighting | 9.57 | 16.71 | 0.057 | 1.15 | 不一致 |
| Jewellery & Accessory | -48.27 | -32.85 | 0.242 | -2.65 | 一致 |
两口径 Spearman 相关 0.9636、象限一致 10/11,四象限划分稳健。但 Christmas 品类差值达 114.65 个百分点且趋势不显著(R² 仅 0.131、t = 1.82),月度波动系数 1.257 为全表最高——同比把旺季相位差算成了增速,其「高增长」应谨慎解读。全表仅 3 个品类趋势通过显著性检验(|t| ≥ 2.07),据此 §6.3 建议对不显著品类只给方向性意见、不做量化承诺。
流失预警最容易被质疑的不是「AUC 多少」,而是三个更根本的问题:这个分数是模型的极限还是调参不够?换个时间窗口还成立吗?按概率阈值触达真的划算吗?本项目逐一给出可核查的答案。
① 分层可预测性:一次性客户的流失不可预测,这是数据的上限
| 客群 | 客户数 | 流失率 | 预测特征 | CV_AUC | 结论 |
|---|---|---|---|---|---|
| 一次性客户(历史仅 1 次购买) | 1,593 | 86.06% | 全量 RFM 行为特征(14 维) | 0.5481 | 近乎随机,不可预测 |
| 一次性客户 | 1,593 | 86.06% | 首购特征集(6 维,换特征重试) | 0.5464 | 换特征也救不回来 |
| 复购客户(历史 ≥2 次购买) | 1,662 | 62.88% | 全量 RFM 行为特征(14 维) | 0.7022 | 有实际预测能力 |
一次性客户占样本 49%,他们没有可供学习的行为历史。为排除「特征选得不好」这一解释,另用首购特征集(首购金额、品类数、距观测窗末天数等)重做,AUC 仍为 0.5464。这个「不可预测」本身就是业务结论:对这批客户做精准挽留是无效投入,资源应转向改善首购体验。
② 多窗口时间外稳健性:换个窗口还成立
| 表现窗 | 窗口类型 | 样本数 | 流失率 | AUC | KS |
|---|---|---|---|---|---|
| 2011-08-31 ~ 2011-11-30 | 主建模窗口(样本内拟合) | 3,255 | 74.22% | 0.7292 | 0.3533 |
| 2011-05-31 ~ 2011-08-31 | 前移 3 个月 | 3,016 | 80.01% | 0.7439 | 0.3662 |
| 2011-02-28 ~ 2011-05-31 | 前移 6 个月 | 2,682 | 79.60% | 0.7201 | 0.3473 |
| 2010-11-30 ~ 2011-02-28 | 前移 9 个月 | 2,448 | 79.49% | 0.7100 | 0.3411 |
三个时间外窗口 AUC 落在 0.7100–0.7439,波动仅 0.034 且无衰减趋势——模型学到的是跨时间稳定的行为规律,不是某个窗口的噪声。
② 续:窗口长度敏感吗?—— 不敏感
| 表现窗 | 窗口类型 | 样本数 | 流失率 | AUC | PR_AUC | KS |
|---|---|---|---|---|---|---|
| 2011-10-31 ~ 2011-11-30 | 长度 1 个月 | 3,555 | 86.53% | 0.7172 | 0.9325 | 0.3343 |
| 2011-08-31 ~ 2011-11-30 | 长度 3 个月(本文采用) | 3,255 | 74.22% | 0.7292 | 0.8611 | 0.3533 |
| 2011-05-31 ~ 2011-11-30 | 长度 6 个月 | 3,016 | 64.66% | 0.7198 | 0.7940 | 0.3358 |
| 2011-02-28 ~ 2011-11-30 | 长度 9 个月 | 2,682 | 56.90% | 0.7114 | 0.7260 | 0.3230 |
「3 个月未购买即流失」是人为阈值。固定截止日 2011-11-30、只放宽表现窗长度后,四种长度 AUC 极差仅 0.018(0.7114–0.7292),排序能力对窗口长度不敏感;窗口越长流失率越低(86.53% → 56.90%),符合「窗口越长、被判流失的门槛越高」的直觉。
③ 阈值成本收益:按概率硬切不经济,应按期望损失排序
在 4 组「触达成本率 × 挽回率」情景下各扫描 6 档触达比例(5%–50%),所有情景的净收益都随触达比例单调上升,在扫描上限 50% 处仍未出现峰值。这说明高低概率客户之间的价值差异比概率差异更能决定「走了亏多少」。因此预警名单按 期望损失 = 流失概率 × 历史累计消费 排序,取前 300 位,合计期望损失 £365,989(相当于主样本 3,255 位客户历史累计消费总额 401.21 万英镑的 9.12%)。
④ 集成消融:不值得
逻辑回归与随机森林的交叉验证样本外概率等权平均后,AUC 仅从 0.7241 升至 0.7244(+0.0003),远不足以抵消复杂度与可解释性损失,故采用单一逻辑回归。方法细节:集成概率必须来自交叉验证的样本外预测,若直接用训练集拟合概率求平均,会得到 0.7625 这类虚高值。
分析的价值最终要落到决策上。论文 §6.3 基于模型证据提出 5 条核心建议 (落在模板「3–5 条」要求内,均为中短期可排期执行)与 1 条战略性延伸建议, 每条都配了优先级与可观测的 KPI,使建议落地后能被反向检验。
| 建议 | 核心模型证据 | 量化预期效果 | 优先级 | 效果度量指标(KPI) |
|---|---|---|---|---|
| 重要价值客户专属运营 | RFM:1,069 人(28.69%)贡献 69.99% 营收 | 留存率每 +1pp ≈ 保住 £3.5 万/年 | P1 | 该群季度留存率、人均年贡献额 |
| ABC 重构库存资金配置 | 帕累托:22.17% SKU 贡献 80% 销售额 | 库存周转效率 +30%,不影响 80% 营收盘子 | P1 | A 类现货率、C 类 SKU 占比 |
| 组合陈列 + 捆绑优惠 | Apriori:3,866 条规则,最强提升度 16.11 | 提升连带率与客单价 | P2 | 连带率(件/单)、组合订单占比 |
| 提前 8 周备货 + CI95 安全库存 | 预测 MAPE 34.70%,11 月峰值 £42.05 万 | 降低旺季缺货损失,抑制季末积压 | P2 | 旺季缺货率、季末滞销库存占比 |
| 分层召回沉睡客群 | K-Means:1,761 人(47.26%)全部仅购买 1 次,人均 £357 | 召回 ROI ≥ 3:1(单次触达成本 <£5) | P1 | 30 日回流率、单次召回成本 |
| 延伸建议:市场多元化(战略) | 结构分析:英国单一市场占 84.96% | 英国营收占比降至 80% 以下 | P3 | 非英营收占比、德/法新客净增数 |
优先级口径:P1 低成本、收益确定,一个月内可启动;P2 需跨部门配合,一个季度内排期, 建议先小范围 A/B 验证;P3 属战略性结构调整,纳入年度规划而非季度考核。
随机种子在 scripts/utils/config.py 中固定为 2026,任何人克隆后均可得到完全一致的结果。
已实测:干净目录导出复跑后 163 项产物(37 图 + 101 表 + 22 组件 + 论文等)字节级全部一致,
详见仓库 docs/复现验证报告.md。
# 1. 克隆仓库
git clone https://github.com/heee-a/business-data-analysis.git
cd business-data-analysis

# 2. 安装依赖(建议 Python 3.11+ 虚拟环境)
pip install -r requirements.txt

# 3. 一键复现全部结果(10 个阶段,约 8 分钟)
python run_all.py

# 常用参数:--list 查看阶段 | --only 4 5 仅出图 | --skip 1 2 跳过取数与清洗